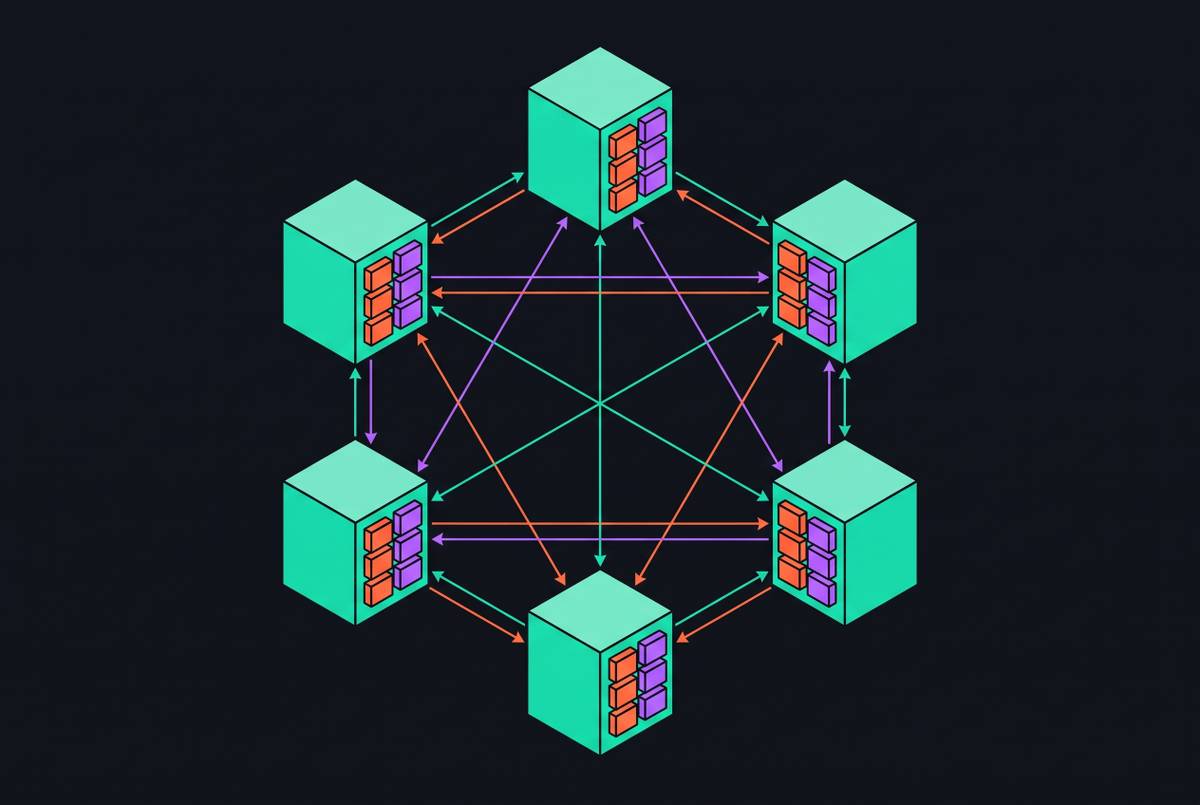
Distributed KV Cache Across Inference Nodes
Splitting prefill and decode across GPUs demands careful network planning.
Dara Haddad
Staff Writer
Dara Haddad is a staff writer at Inference Engineering covering kv cache systems. Based in New York, Dara has written for Inference Engineering since 2022.
1 story · New York
Splitting prefill and decode across GPUs demands careful network planning.